Bases de données
Extension — hors de la promesse de stabilité 1.0 (
database; le cœur)
Un bloc database dit comment un système garde ses données : les tables, leurs
clés et les relations entre elles. Vous écrivez une table comme vous écrivez
une struct. archec lit le même bloc de quatre façons. archec check résout
chaque relation des deux côtés et dit ce qui ne tient pas.
archec gen --target sqlite (ou postgres, clickhouse, duckdb, mongodb)
écrit le schéma et un code d'accès typé. archec database migrate écrit la
migration depuis une version antérieure. Le simulateur garde la base en
mémoire : un cas de test écrit des lignes, les relit, et prouve les règles sur
les données.
Cette page construit une petite boutique : des clients, des produits, des
commandes et leurs lignes. Le modèle terminé est examples/shop/main.arche.
Ce qu'il vous faut#
Écrire, vérifier, simuler et générer ne demandent rien de plus qu'archec. Aucune base de données n'est installée, et il n'en faut aucune pour exécuter les tests.
Les fichiers qu'écrit archec sont pour la base que vous nommez. Pour les
exécuter, il vous faut cette base et son pilote : sqlite3 vient avec Python,
les autres sont pip install "psycopg[binary]", duckdb, clickhouse-connect
ou pymongo.
1. Une table#
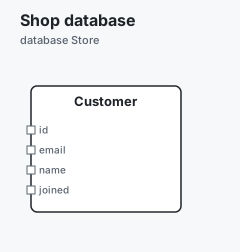
database Store "Shop database" {
  table Customer "Customer" {
    id:     int64     = autoincrement key
    email:  string    unique
    name:   string    "Name"
    joined: timestamp = now
  }
}
| Vous écrivez | Sens |
|---|---|
database Store |
Une base de données. Le code la nomme : Store.Customer.find(1). |
table Customer |
Une table. Ses champs sont ses colonnes. |
id: int64 |
Une colonne, écrite comme le champ d'une struct : name: Type = default "Label" unit u range lo..hi. |
key |
Ce champ est la clé de la table (sa clé primaire). |
unique |
Deux lignes n'ont jamais la même valeur. |
index |
Un index sur le champ, pour les recherches par ce champ. |
= autoincrement |
La base donne l'entier suivant. |
= now |
L'heure à laquelle la ligne est écrite. Le champ est un timestamp. |
= uuid |
Un nouvel identifiant. Le champ est une string. |
= 1, = "new", = Open |
Toute autre valeur par défaut est une valeur. |
optional string |
Le champ peut être vide. Tout autre champ a toujours une valeur. |
Le type d'une colonne est un type de données (bool, int8 à int64, uint8
à uint64, float32, float64, string, bytes, timestamp, duration),
un type du modèle, un enum ou une struct. Une liste s'écrit string[].
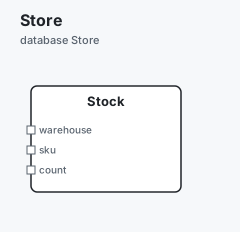
Pour une clé de plusieurs champs, écrivez une ligne sur la table. unique et
index prennent plusieurs champs de la même façon, et peuvent s'écrire
plusieurs fois :
database Store {
  table Stock {
    warehouse: string
    sku:       string
    count:     int32 = 0
    key warehouse, sku
    index sku
  }
}
Une table a une clé. Une table sans clé est une erreur, avec une correction
rapide qui ajoute id: int64 = autoincrement key.
2. Relations#
Un champ dont le type est une autre table est une relation.
enum OrderStatus { Open, Paid, Shipped }

database Store {
  table Customer {
    id:     int64 = autoincrement key
    orders: Order[]
  }

  table Order {
    id:       int64       = autoincrement key
    customer: Customer    on-delete cascade
    status:   OrderStatus = Open
  }
}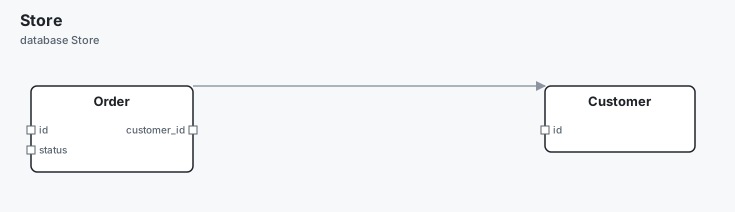
customer: Customer contient la clé du client. La table reçoit la colonne
customer_id : le nom du champ, puis le nom de la clé vers laquelle il pointe.
C'est une clé étrangère.
orders: Order[] est la même relation, vue du client. Elle ne contient aucune
colonne. Vous pouvez l'omettre : elle est là pour que le code puisse demander
les commandes d'un client.
| Vous écrivez | Relation |
|---|---|
customer: Customer sur Order |
Plusieurs commandes pour un client. |
customer: optional Customer |
Pareil, et une commande peut n'en avoir aucun. |
orders: Order[] sur Customer |
L'autre côté de la même relation. |
user: User unique sur Profile |
Un à un : au plus un profil par utilisateur. |
profile: optional Profile via user sur User |
L'autre côté d'un un-à-un. |
tags: Tag[] avec une table de jointure |
Plusieurs à plusieurs. |
on-delete dit ce qui arrive à la commande quand son client est supprimé :
restrict |
La suppression est refusée tant qu'une commande pointe vers le client. C'est la valeur par défaut. |
cascade |
La commande est supprimée aussi. |
set-null |
Le customer de la commande est vidé. Le champ doit être optional. |
no-action |
Comme restrict, vérifié à la fin de la transaction quand la base le permet. |
Quel champ est l'autre côté#
archec trouve l'autre côté tout seul quand un seul champ de l'autre table
pointe en retour. Quand deux le font, dites lequel avec via :
database Blog {
  table User {
    id:       int64  = autoincrement key
    written:  Post[] via author
    reviewed: Post[] via reviewer
  }

  table Post {
    id:       int64 = autoincrement key
    author:   User
    reviewer: optional User on-delete set-null
  }
}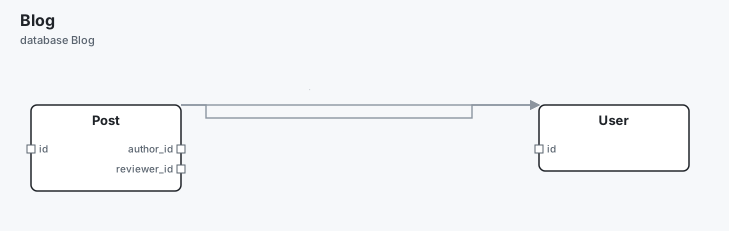
Sans via, l'erreur le dit, et sa correction rapide écrit le premier :
main.arche:4:5 error Post points at User 2 times (author, reviewer): say which one written is the other side of — `via author` [database-relation]Plusieurs à plusieurs#
Plusieurs des deux côtés passe par une table de jointure : une table avec un champ vers chacune. Sa clé est en général les deux ensemble.
database Store {
  table Product {
    sku:    string key
    orders: Order[]
  }

  table Order {
    id:       int64     = autoincrement key
    products: Product[] via OrderLine
  }

  table OrderLine {
    order:    Order on-delete cascade
    product:  Product
    quantity: int32 = 1 range 1..100
    key order, product
  }
}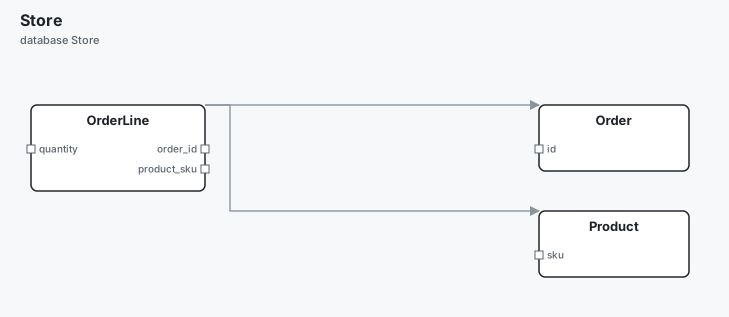
key order, product nomme les relations : la clé est faite des colonnes
qu'elles contiennent, order_id et product_sku. Quand une seule table relie
les deux, via peut être omis, comme sur orders: Order[].
Une struct dans une ligne#
Un champ dont le type est une struct est gardé dans la ligne : une colonne
JSON dans PostgreSQL, un STRUCT dans DuckDB, un Tuple dans ClickHouse, un
sous-document dans MongoDB. Une liste de structs s'écrit Address[].
struct Address {
  street: string
  city:   string
}

database Store {
  table Customer {
    id:      int64 = autoincrement key
    address: optional Address
  }
}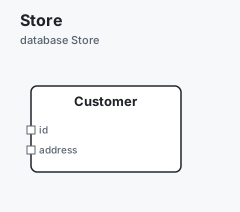
C'est donc le modèle qui choisit : un champ du type d'une struct est intégré, un champ du type d'une table est une référence vers une autre ligne.
3. Règles sur les données#
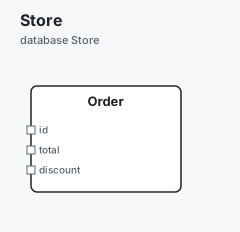
Le range d'un champ est une règle : la base refuse une valeur hors de cet
intervalle. Une ligne check est une condition que chaque ligne respecte, sur
ses champs, écrite dans le langage d'action :
database Store {
  table Order {
    id:       int64   = autoincrement key
    total:    float64 unit EUR range 0..100000
    discount: float64 = 0.0
    check discount <= total
  }
}
Une règle peut dire quelle exigence elle satisfait. Écrivez satisfies sur le
champ, sur la table ou sur la base :
requirement REQ-EMAIL "One account per email" {
  text "Two customers shall not have the same email address."
}

database Store {
  table Customer {
    id:    int64  = autoincrement key
    email: string unique satisfies REQ-EMAIL
  }
}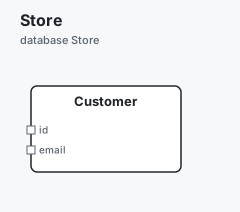
archec status montre alors la règle à côté de l'exigence, avec ce qui l'a
prouvée (section 7).
4. Fournisseurs#
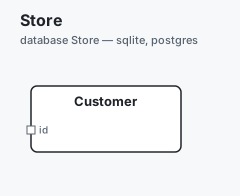
Un fournisseur (provider) est la base de données pour laquelle le schéma est écrit. Une base en nomme un ou plusieurs :
database Store {
  provider sqlite, postgres
  table Customer {
    id: int64 = autoincrement key
  }
}
archec en fournit cinq, chacun un plugin dans lib/plugins/ :
| Fournisseur | Fait respecter | Ne fait pas respecter | Écrit |
|---|---|---|---|
sqlite |
clés, unique, clés étrangères avec on-delete, checks, champs obligatoires, autoincrement |
listes et structs (gardées en texte JSON) ; une contrainte modifiée sur place | schema.sql, Python (sqlite3), C (l'API C de sqlite3) |
postgres |
tout | schema.sql, Python (psycopg) |
|
duckdb |
clés, unique, clés étrangères, checks, champs obligatoires, séquences | on-delete cascade et set-null ; une contrainte ajoutée à une table existante |
schema.sql, Python (duckdb), TypeScript (@duckdb/node-api) |
clickhouse |
champs obligatoires, checks sur les lignes écrites | clés, unique, clés étrangères | schema.sql, Python (clickhouse-connect) |
mongodb |
la clé (_id), unique (un index unique), champs obligatoires, intervalles et checks (le validateur) |
références vers une autre collection ; les transactions demandent un replica set | schema.js (mongosh), TypeScript (mongodb), Python (pymongo) |
archec database providers main.arche liste les fournisseurs que le projet
voit, ce que chacun fait respecter, et les options qu'il accepte.
Ce qu'un fournisseur ne fait pas respecter#
Le modèle dit une règle une fois. Un fournisseur qui ne peut pas la tenir est signalé, là où la règle est écrite :
main.arche:26:13 warning The relation Reading.device → Device: ClickHouse does not enforce it (it has no `foreign-keys`) — the model checks it in the simulator, the database will not [database-not-enforced]Rien n'est écrit dans le schéma pour une règle que le fournisseur n'a pas. Le simulateur la vérifie quand même, et la preuve dit qui tient la règle (section 7).
Les options propres à un fournisseur#
Ce que seule une base possède s'écrit dans options <provider> { … }, sur la
base, une table ou un champ. Le fournisseur déclare chaque option, et
archec check vérifie la valeur par rapport à cette déclaration.
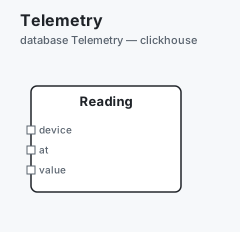
database Telemetry {
  provider clickhouse

  table Reading {
    device: string
    at:     timestamp = now options clickhouse { codec "Delta, ZSTD(1)" }
    value:  float64   options clickhouse { type "Decimal(12, 3)" }
    key device, at
    options clickhouse {
      engine ReplacingMergeTree
      engine-args at
      partition-by "toYYYYMM(at)"
      ttl "at + INTERVAL 90 DAY"
    }
  }
}
main.arche:10:7 error 'engin' is not an option clickhouse takes on a table (engine, engine-args, order-by, …). Did you mean 'engine'? [database-option]
main.arche:10:14 error engine: "FastTree" is not one of "MergeTree", "ReplacingMergeTree", … [database-option]
Tout fournisseur accepte type sur un champ : le type de la colonne dans cette
base, quand ce n'est pas celui auquel correspond le type du modèle
(Decimal(18, 4), LowCardinality(String), HUGEINT, objectId).
ClickHouse. Une table accepte engine (MergeTree et sa famille, Log,
Memory), engine-args, order-by (la clé de tri : la clé de la table si
rien n'est dit), primary-key, partition-by, sample-by, ttl, settings
et materialized-view (un SELECT qui remplit la table, écrit comme
CREATE MATERIALIZED VIEW <table>_mv TO <table>). Un champ accepte type,
low-cardinality, enum16, codec, default, materialized, alias et
ttl. Un champ optionnel est Nullable, une liste est Array, un enum est
Enum8, une struct est un Tuple nommé. options clickhouse { cluster "main" }
sur la base écrit ON CLUSTER.
DuckDB. Les index sont des index ART : CREATE INDEX est écrit pour chaque
index, mais DuckDB ne les recommande que pour les recherches ponctuelles, car
ses parcours sont rapides sans index. Une liste est T[], une struct est un
STRUCT, un enum est un CREATE TYPE … AS ENUM, = autoincrement est une
séquence.
MongoDB. Une table est une collection. Une clé d'un seul champ est l'_id
du document ; options mongodb { object-id } dessus en fait un ObjectId, que
le pilote crée. Une clé de plusieurs champs est un index unique. Une table
accepte collection, additional-properties, validation-level,
validation-action, text et geo (un index texte, des index 2dsphere). Un
champ accepte type, object-id, expire-after (un index TTL, en secondes)
et partial (son index ne couvre que les documents qui ont le champ). Le
schéma est un script mongosh, schema.js : un db.createCollection avec son
validateur $jsonSchema par table, puis les appels à createIndex.
5. Le schéma et le code d'accès#
archec gen main.arche --target sqlite -o generated generated/sqlite/Store/schema.sql
generated/sqlite/Store/store_db.py
generated/sqlite/Store/store_db.h
generated/sqlite/Store/store_db.cschema.sql crée les tables, en commençant par celles vers lesquelles une
autre pointe :
CREATE TABLE "Order" (
  "id" INTEGER PRIMARY KEY AUTOINCREMENT,
  "customer_id" INTEGER NOT NULL,
  "status" TEXT NOT NULL DEFAULT 'Open',
  "total" REAL NOT NULL DEFAULT 0,
  "placed" TEXT NOT NULL DEFAULT (strftime('%Y-%m-%dT%H:%M:%fZ', 'now')),
  CHECK ("status" IN ('Open', 'Paid', 'Shipped')),
  CONSTRAINT "Order_check_1" CHECK ("total" >= 0),
  FOREIGN KEY ("customer_id") REFERENCES "Customer" ("id") ON DELETE CASCADE
);
CREATE INDEX "Order_customer_id_placed_idx" ON "Order" ("customer_id", "placed");
Le code d'accès a un type par table et les mêmes recherches dans chaque langage :
insert(row) |
Une nouvelle ligne. Un champ omis prend sa valeur par défaut. |
find(key…) |
La ligne qui a cette clé, ou rien. |
by_<field>(value) |
Pour chaque champ unique : la ligne. Pour chaque index : les lignes. |
where(filter), all(), count(filter) |
Les lignes dont les champs sont égaux à ceux du filtre. |
update(key…, changes) |
Modifie la ligne qui a cette clé. |
delete(key…) |
Supprime la ligne qui a cette clé. |
<relation>(row) |
Suit une relation : customer(order), orders(customer), products(order). |
En Python :
import sqlite3
from store_db import Store

conn = sqlite3.connect("store.sqlite3")
conn.execute("PRAGMA foreign_keys = ON")
db = Store(conn)

ann = db.Customer.insert(email="ann@example.org", name="Ann")
order = db.Order.insert(customer_id=ann.id, total=79.0)
db.Customer.by_email("ann@example.org").id      # 1
db.Order.customer(order).name                   # "Ann"
[o.total for o in db.Customer.orders(ann)]      # [79.0]
En C, une ligne est une struct, et une liste est donnée une ligne à la fois :
sqlite3 *db;
store_open("store.sqlite3", &db);

store_customer_t ann = {0}, saved;
ann.email = "ann@example.org";
ann.name = "Ann";
store_customer_insert(db, &ann, &saved);        /* 1, or -SQLITE_CONSTRAINT when refused */

store_customer_t found;
if (store_customer_by_email(db, "ann@example.org", &found) == 1) store_customer_free(&found);
Un champ qui peut être absent (optionnel, ou avec une valeur par défaut) a un
has_<field> à côté de lui. Le texte que contient une ligne appartient à la
ligne : store_customer_free le libère.
Le code généré ne demande que le pilote de la base. Rien de lui n'est compilé quand archec est compilé ou testé.
6. Migrations#
Une migration s'écrit à partir de ce qui a changé entre deux versions du
modèle. --since nomme la version antérieure :
--since |
La version antérieure |
|---|---|
v1.0 |
La baseline baselines/v1.0.json (archec baseline main.arche --name v1.0 garde le schéma de chaque base). |
main~3, v0.4.0 |
Une révision git : le dossier du projet tel qu'il était. |
old/main.arche |
Un autre fichier. |
archec database diff main.arche --since v1.0database Store since baseline v1.0
+ Customer.phone is new (string, optional)
✗ Order.note is new (string) destructive — note is required and has no default: the rows there are have no value for it
✗ Order: customer_id, placed now unique destructive rebuilds the table — a unique constraint cannot be changed in place in sqlite: the table is made again and its rows copiedarchec database migrate main.arche --since v1.0 --name add-phone -o generatedChaque fournisseur de la base écrit son propre fichier,
generated/<provider>/<Database>/migrations/add-phone.sql.
Un changement destructif n'est jamais appliqué sans qu'on le demande. Une
table ou une colonne supprimée, un type rendu plus étroit, un champ devenu
obligatoire, une contrainte que les lignes existantes pourraient violer :
chacun est écrit en commentaire, marqué DESTRUCTIVE avec la raison, et listé
par la commande. Lisez-le, puis exécutez-le vous-même, ou relancez la migration
avec --allow-destructive pour qu'il soit écrit comme des instructions.
-- Order.total: float64 → float32
-- DESTRUCTIVE: float64 → float32 is narrower or another kind: values there may not fit. Not applied: read it, then run it yourself (or migrate with --allow-destructive).
-- ALTER TABLE "Order" ALTER COLUMN "total" TYPE REAL USING "total"::REAL;
Un changement qui ne peut pas se faire sur place reconstruit la table.
SQLite et DuckDB ne peuvent pas ajouter une contrainte à une table existante ;
ClickHouse ne peut pas changer un moteur, une clé de tri ou une partition. La
migration refait alors la table et copie ses lignes, sous un commentaire
REBUILD. Pour ClickHouse, la reconstruction est toujours laissée en
commentaires : elle copie chaque ligne.
MongoDB. La migration est un script mongosh : collMod avec le nouveau
validateur, puis les index supprimés et créés. Un changement que les documents
existants doivent suivre vient d'abord, comme une étape de données : un
squelette updateMany pour un champ devenu obligatoire ou un type rendu plus
étroit, $unset pour un champ supprimé, et $rename proposé quand un champ a
été supprimé et un autre du même type ajouté. Chacun est marqué DATA et
laissé en commentaire jusqu'à ce que vous ayez écrit sa valeur.
archec database migrate --check n'écrit rien et sort avec 1 quand quelque
chose a changé : pour un pipeline qui veut que chaque changement vienne avec sa
migration.
archec ne voit pas un renommage. Un champ renommé est un champ supprimé et un champ ajouté ; la migration le dit à côté d'eux, avec l'instruction qui renomme à la place.
7. Cas de test sur la base du simulateur#
Le simulateur garde chaque base en mémoire. Elle part vide à chaque cas. Un cas écrit des lignes et les relit :
test-plan TP-SHOP "The shop's data" {
  case TC-EMAIL "Two customers cannot share an email" {
    verifies REQ-EMAIL
    at 0ms do Store.Customer.insert({ email: "ann@example.org", name: "Ann" })
    at 1ms do Store.Customer.insert({ email: "ann@example.org", name: "Another Ann" })
    at 2ms expect Store.Customer.count() == 1
    at 2ms expect Store.refused("unique") == 1
    at 2ms expect Store.Customer.by_email("ann@example.org").name == "Ann"
  }
}
Une ligne nomme la base comme le fait le code : <Database>.<Table>.<what>(…),
puis un champ de ce qui revient. Un do est une écriture : insert, update
ou delete. Un expect peut mêler ce qu'il lit d'une base et les variables
des parties : expect Store.Order.count() == 1 and till.placed == 1.
Chaque écriture est vérifiée par rapport au schéma : la clé, chaque unique,
chaque relation, chaque check et range, chaque champ obligatoire, le type
de chaque valeur. Une écriture qui viole une règle est refusée. Elle est
enregistrée, et le cas continue. Store.refused() compte les écritures
refusées jusque-là : toutes, celles d'une règle ("key", "unique",
"foreign-key", "check", "required", "type"), ou celles sur une chose
("Customer.email").
Une ligne est vérifiée par rapport au schéma quand le modèle est vérifié :
main.arche:152:38 error Customer has no field 'mail' (id, email, name, address, joined). Did you mean 'email'? [database-line]archec sim main.arche --test # the cases, on the simulator
archec test main.arche # the same, recorded as evidenceData rules: 3 checked on the simulator's database
✓ Store: unique Customer.email → REQ-EMAIL — held on 6 write(s), 1 of them refused by it (…); checked by the model, and enforced by SQLite, PostgreSQLarchec test enregistre deux sortes de preuves. Chaque cas est un
enregistrement, comme tout cas. Chaque règle qui dit satisfies en est un
aussi : sur combien d'écritures elle a été vérifiée, combien elle en a
refusé, et qui la tient hors du simulateur. Pour un fournisseur qui ne fait
pas respecter la règle, l'enregistrement le dit :
checked by the model; not enforced by ClickHouse: there, only the model keeps itarchec status montre les deux à côté de l'exigence. Une table qui change les
rend périmées.
Dans un handler#
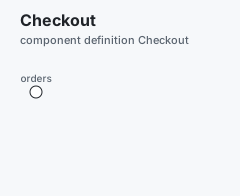
Un handler nomme la base de la même façon. En TypeScript, le langage par défaut :
component Checkout "Checkout" {
  in orders: data receives PLACE_ORDER {
    on-receive ```ts
      const product = Store.Product.find(msg.sku)
      if (!product) return
      const order = Store.Order.insert({ customer_id: msg.customer, total: product.price * msg.quantity })
      Store.OrderLine.insert({ order_id: order.id, product_sku: product.sku, quantity: msg.quantity })
    ```
  }
}
Une ligne est telle que la base la garde : une relation qui contient une clé
est sa colonne (customer_id), et se suit par son nom
(Store.Order.customer(order)). Dans un handler, une écriture refusée lève une
exception, comme le fait un pilote.
archec check vérifie un corps par rapport au schéma : la table, ce qui en est
appelé, et les champs d'une ligne écrite dans l'appel. archec stubs écrit les
types dans arche.d.ts, pour que l'éditeur et tsc vérifient aussi les
valeurs :
Store.Order.insert({ customer_id: 1, totl: 12 })
//                                   ~~~~ 'totl' does not exist in type 'NewOrder'
Pourquoi une écriture a été refusée#
archec why main.arche --test TC-EMAIL "Store.Customer refused"Store.Customer.insert refused: a Customer with email = ann@example.org is there already at 1.000 ms
← the rule: unique Customer.email main.arche:46
satisfies REQ-EMAIL "One account per email"
checked by the model, and enforced by SQLite, PostgreSQL
← the row in the way: Customer [1], written at 0.000 ms
asked by the test main.arche:155
← asked by the test main.arche:156archec why … "Store.Order delete" dit qui a demandé une écriture : le test,
une partie qui traite un message, ou une suppression en cascade, avec la
relation qui le dit. archec why-not … "Store.Order insert" dit pourquoi une
écriture n'a jamais eu lieu : elle a été tentée et refusée, avec la règle, ou
rien ne l'a demandée, avec le code qui l'aurait fait et si ce code s'est
exécuté.
Écrire un fournisseur#
Un fournisseur est un plugin générateur (plugins,
générateurs) qui dit provides database. Il est trouvé et
approuvé comme tout plugin : dans plugins/<name>/ à côté du modèle, dans une
bibliothèque de kind plugin que le projet uses (son script s'exécute une
fois approuvé, avec archec plugin approve), dans ARCHE_PLUGINS, ou intégré.
archec n'a aucune ligne propre à une base en particulier : les cinq qu'il
fournit sont écrits de cette façon, dans lib/plugins/.
Un fournisseur tient en deux fichiers. plugins/memdb/plugin.arche le
déclare :
generator memdb "MemDB" {
  provides database
  script "provider.ts"
  capabilities primary-key, required
  types { int64 "i64"; string "text"; bool "bit"; float64 "f64" }
  option shard "Which shard the table is kept on" { on table; type int; rebuild }
  option compress "How the column is packed" { on field; type string; values none, lz4 }
}| Vous écrivez | Sens |
|---|---|
provides database |
Le générateur est un fournisseur de base de données. Une base peut le nommer. Un nombre après est la version de ce contrat qu'il lit (1). |
capabilities |
Ce qu'il fait respecter ou contient : primary-key, unique, foreign-keys, on-delete, check, required, auto-increment, transactions, indexes, lists, embedded, alter-constraints. Ce qu'un modèle utilise et que le fournisseur ne liste pas est signalé (database-not-enforced). |
types { … } |
Les types du modèle, tels qu'il les nomme. Une colonne d'un type qu'il ne nomme pas est une erreur, sauf si le champ donne le sien avec l'option type. |
option … { on table } |
Une option écrite on une database, une table ou un field, dans options memdb { … }. Son type, ses values et son default sont vérifiés comme ceux de toute option de générateur. |
rebuild |
L'option ne peut pas changer sur place : une migration qui la change est marquée comme reconstruisant la table. |
archec lit ces déclarations pour vérifier un modèle. Il n'exécute pas le code du fournisseur pour cela.
plugins/memdb/provider.ts écrit les fichiers :
export default function generate(model, ctx) {
  const files = {};
  const types = model.provider.types;
  for (const db of model.databases.filter((d) => d.providers.includes('memdb'))) {
    if (model.migration) {
      // `archec database migrate`: what changed since db.since
      const lines = db.changes.map((c) => `${c.rebuild ? 'REBUILD' : c.destructive ? 'DANGER' : 'DO'} ${c.kind} ${c.table ?? ''}`);
      for (const c of db.changes) if (c.destructive) ctx.warn(db.tables.find((t) => t.id === c.table) ?? db, c.text);
      files[`${db.id}/migrations/${model.migration.name}.txt`] = lines.join('\n') + '\n';
      continue;
    }
    // `archec gen --target memdb`: the schema
    const out = [];
    for (const t of db.tables) {
      out.push(`table ${t.id} key(${t.key.join(',')})`);
      for (const c of t.columns) out.push(`  ${c.id} ${types[c.type] ?? '?'}${c.optional ? '?' : ''}`);
    }
    files[`${db.id}.memdb`] = out.join('\n') + '\n';
  }
  return { files };
}
Le script lit le modèle du générateur. Un modèle avec une base de données a trois clés de plus :
| Clé | Ce qu'elle contient |
|---|---|
databases |
Chaque base, résolue : id, providers, options, enums, et ses tables. Une table a ses columns (id, type, optional, list, default, key, unique, range, references pour la colonne d'une clé étrangère, enum et values, struct et fields, options), sa key, ses uniques, indexes, relations (to, kind, holds, columns, references, onDelete, inverse, through) et checks (text, sql, et tree pour une base qui n'est pas SQL). |
provider |
Ce que le fournisseur a déclaré : id, capabilities, types, options. |
migration |
Seulement pour archec database migrate : name, since, allowDestructive. Chaque base a alors previous (le schéma antérieur) et changes. |
Un changement a un kind (add-table, drop-table, add-column,
drop-column, alter-column, change-key, add-unique, drop-unique,
add-index, drop-index, add-relation, drop-relation, alter-relation,
add-check, drop-check, change-option, add-enum-value,
drop-enum-value), la table et la column qu'il concerne, from et to,
un text qui le dit, et deux drapeaux qu'archec pose : destructive (il perd
des données, ou les lignes existantes pourraient ne pas tenir) et rebuild (il
ne peut pas se faire sur place : une option marquée rebuild, ou une
contrainte quand le fournisseur n'a pas alter-constraints). Ce que le script
signale avec ctx.warn est listé par la commande.
archec generator model main.arche affiche le modèle, et
schemas/generator-model.v1.json le décrit.
Ce qui est vérifié#
| Code | |
|---|---|
database-key |
une table sans clé, deux champs marqués key, une clé optional, une liste ou une struct |
database-relation |
une relation qui ne se résout pas : rien ne pointe en retour, deux champs le font et aucun via ne dit lequel, on-delete du côté qui ne contient pas de colonne, set-null sur un champ qui n'est pas optional |
database-field |
une ligne key, unique ou index qui nomme quelque chose sans colonne |
database-type |
une colonne d'un type qu'une base ne contient pas, ou pour lequel un fournisseur n'a pas de nom |
database-default |
= now sur autre chose qu'un timestamp, = autoincrement sur autre chose qu'un entier, = uuid sur autre chose qu'une string, une valeur d'un autre type |
database-check, database-range |
un check illisible ; un range sur un champ qui n'est pas un nombre |
database-duplicate, database-structure, database-name, database-index |
deux choses du même nom ; quelque chose dans une base qui n'est pas une table ; une base qui porte le nom d'un type ; un index écrit deux fois |
database-provider |
un fournisseur que le projet ne voit pas, ou la déclaration d'un fournisseur qui ne peut pas être lue |
database-option |
une option que le fournisseur ne déclare pas à cet endroit, ou une valeur qu'il n'accepte pas |
database-not-enforced |
une règle qu'un fournisseur de la base ne fait pas respecter (un avertissement) |
database-line |
une ligne de test, ou un corps TypeScript, qui ne correspond pas au schéma |
database-migration |
un changement qui perd des données ou reconstruit une table |
archec explain database-relation en dit plus sur chacun.
Dans VS Code#
- Écriture :
database,tableet les mots d'un champ sont colorés et complétés. Le survol d'une relation dit vers quelle table elle pointe, la colonne qu'elle contient et son autre côté. Ctrl+clic sur le type d'une relation mène à la table, survia authorau champ, sur un fournisseur à sa déclaration. - Problèmes : les vérifications ci-dessus, avec leurs corrections rapides
(ajouter une clé, ajouter
via, rendre un champoptional). - Commandes : Arche: Show Database Layout dessine les tables et leurs relations. Arche: Generate Database Schema… exécute un fournisseur. Arche: Write Database Migration… demande la version antérieure et écrit la migration.
Limites#
- Pas de langage de requête. Le code d'accès cherche les lignes par clé, par un champ unique, par un index, par égalité de champs, et suit les relations. Une jointure, un agrégat ou un tri sont à écrire vous-même en SQL.
- Handlers en TypeScript. La base du simulateur répond aux corps
TypeScript et aux lignes de test. Un corps
```archeet un corps Python ne peuvent pas encore nommer une base ; le simulateur propre d'Arche ne l'a pas, doncarchec testexécute un cas qui nomme une base sur le simulateur du navigateur. - L'accès en C est réservé à SQLite. Les autres fournisseurs écrivent du Python, et DuckDB et MongoDB aussi du TypeScript.
- Pas de renommage. Un champ ou une table renommés sont lus comme un supprimé et un ajouté.
- Une base par version du modèle.
--sincecompare des schémas entiers ; il ne garde pas d'historique des migrations, et ne dit pas lesquelles ont été appliquées. - Le simulateur n'est pas une base de données. Il vérifie les règles du modèle à chaque écriture. Il n'a ni transactions, ni concurrence, ni SQL.
- Ni lu ni écrit :
schema.prisma.